AI 大模型是怎么"收录"知识的?——从零讲清收录规则、各家差异与企业 GEO 打法
2026-10-11 · 合肥凌亿启迪科技有限公司(凌亿启迪)
2026 年,很多企业市场负责人发现一个尴尬的现实:客户在问 AI"XX 行业哪家公司好",而 AI 的回答里没有你。不是你做得不好,而是 AI 压根不"认识"你。这篇文章从零讲清楚:AI 大模型的知识是怎么被"收录"进去的、各家模型收录规则差在哪、以及不同阶段的企业该怎么做 GEO 优化(生成式引擎优化),让品牌获得 AI 可见度。
一、大模型的知识从哪来?先搞懂四层"记忆"
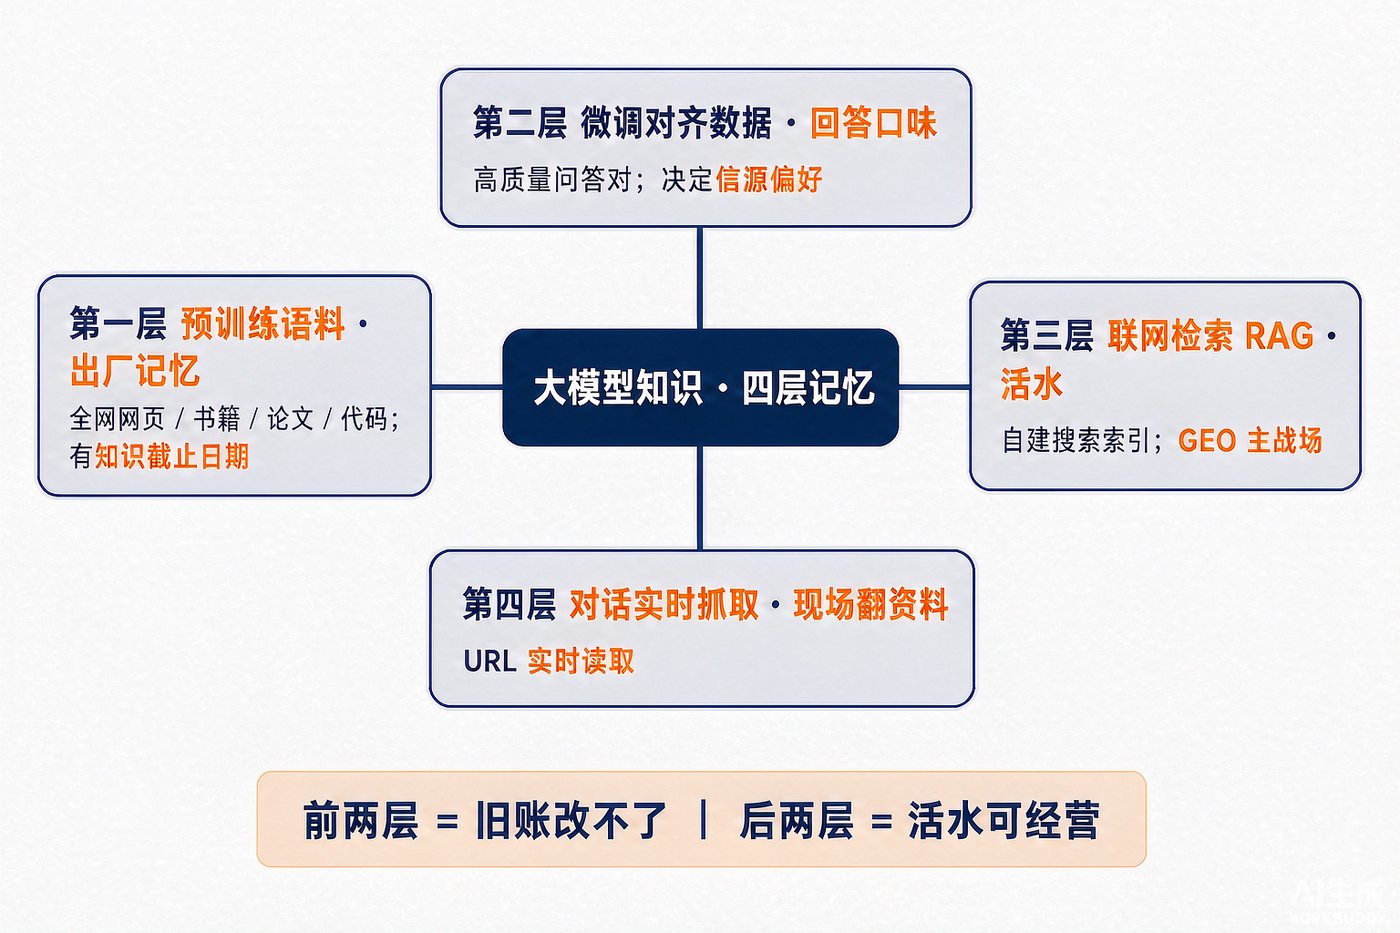
很多人以为大模型什么都知道,其实它的知识是有明确来源、有截止时间的。可以把大模型的"大脑"理解成一个四层结构的记忆系统:
第一层:预训练语料(Pre-training Corpus)——出厂记忆。
大模型在正式发布前,会"读"完海量的人类知识:全网爬取的网页(比如著名的 Common Crawl 数据集)、书籍、学术论文、代码仓库、维基百科等。注意,这一层有个关键设定——知识截止日期(Knowledge Cutoff)。训练数据抓取到某个时间点就封版了,之后发生的事它出厂时一概不知。你的内容想进这一层,必须在截止日期之前就广泛存在于公开互联网上,而且要经得起语料治理管线(抓取 Crawl、清洗 Clean、去重 Dedup、语义切片 Chunking)的层层筛选,才能最终入选"教材"。
第二层:微调与对齐数据(SFT / RLHF)——教养与口味。
在预训练之后,模型还会用一批人工精选的高质量问答对、指令数据进行监督微调(SFT)和基于人类反馈的强化学习(RLHF)。这部分数据量很小,但决定了模型的回答风格与信源偏好——比如它更爱引用权威来源、更倾向结构化表达。这一层企业很难直接干预,但它告诉我们一件事:AI 天生就"喜欢"规范、清晰、权威的内容。
第三层:外部检索——检索增强生成(RAG),随查随用的资料库。
现在的 AI 回答问题前,经常先实时搜索一轮网页再作答,这套机制叫检索增强生成(Retrieval-Augmented Generation, RAG)。这是当前 GEO 最主要的战场。原因很简单:预训练改不了,微调插不进手,但联网检索用的是各家自建的搜索索引——内容被谁家的搜索索引收录了,才有可能被谁家的 AI 引用。
第四层:对话时的实时抓取——现场翻资料。
部分模型支持 URL 实时读取:用户丢一个链接过去,模型现场访问、现场解析正文。这一层量不大,但在客服问答、资料核验等场景里很实用。
一句话总结:前两层是"旧账"改不了,后两层是"活水"可以经营。GEO 优化的核心阵地,就是让内容进入第三、第四层的检索管线,并反过来影响前两层的"下次版本更新"。
二、从内容存在到被 AI 引用:五步链路,步步都可能掉链子
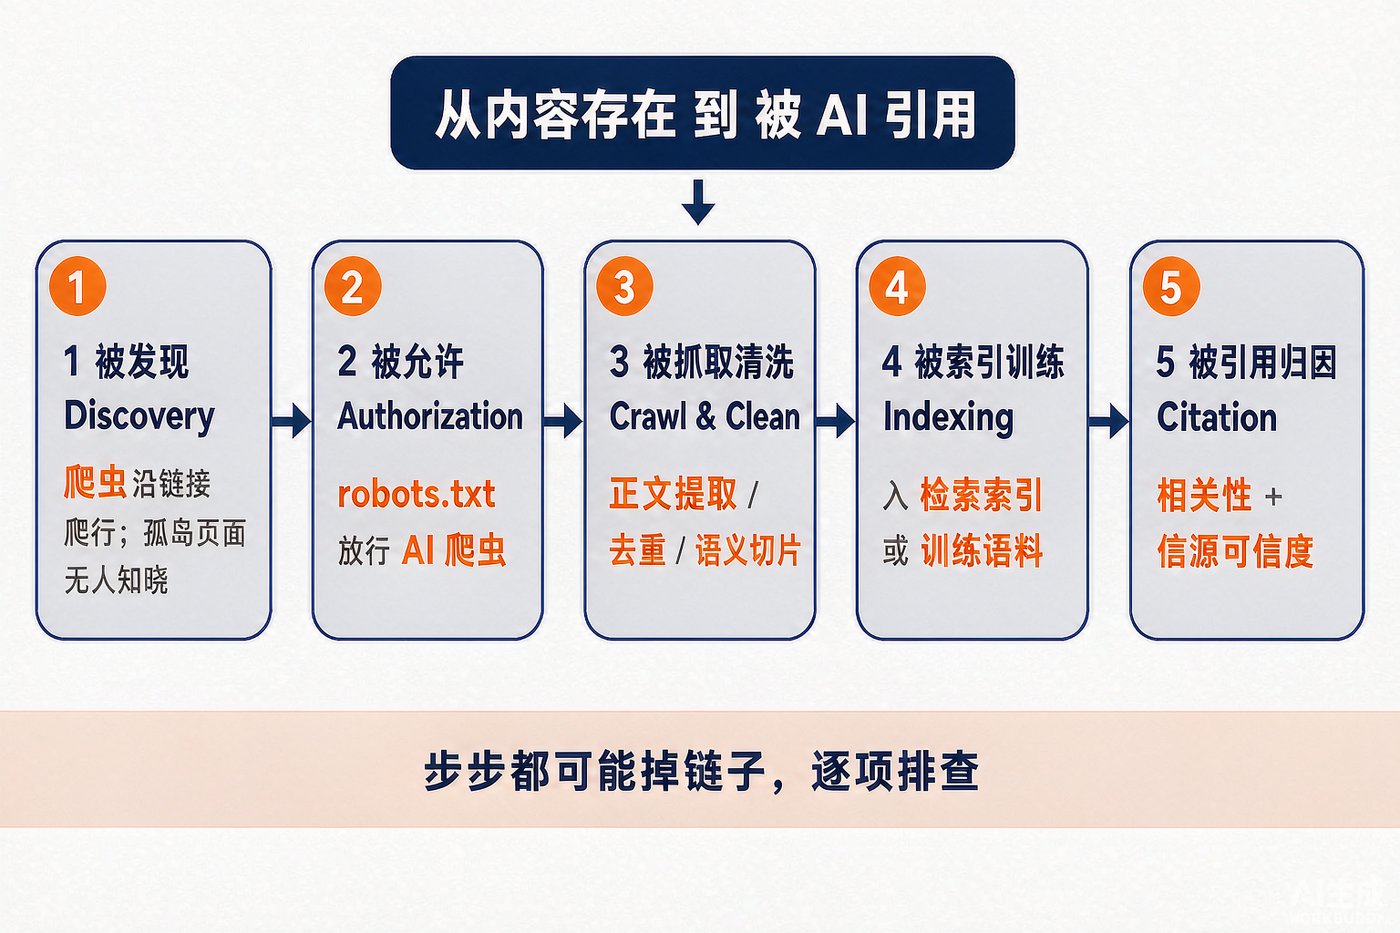
很多企业觉得"我官网内容写了呀,为什么 AI 不知道?"因为从"内容存在"到"被 AI 引用",中间隔着一条五步链路,任何一步断了就前功尽弃:
第一步:被发现(Discovery)。
AI 的网络爬虫(Web Crawler,可以理解为 AI 的"图书管理员",专门去全网收书)不是凭空知道你网页的,它顺着链接拓扑一跳一跳地找过来。一个没有任何外链(Backlink)、不在任何导航和目录里的"孤岛页面",等于图书馆里根本没人知道有这本书。
第二步:被允许(Crawl Authorization)。
每个网站根目录下都有一份 robots.txt,相当于大门上贴的"访客守则":哪些爬虫 UA(User-Agent,用户代理标识)能进、哪些不能。放行 GPTBot(OpenAI 的训练爬虫)、Bytespider(字节的爬虫)等 AI 爬虫,内容才有机会被收录;如果技术上或无意中把 AI 爬虫挡在门外,AI 再想"认识"你也没办法。
第三步:被抓取与清洗(Crawl & Cleaning)。
爬虫进来了,还要把内容抓走,经过正文提取、去重、低质过滤、语义切片,才算完成语料入库前的预处理。大量转载、拼接、低质的内容在这一步就被筛掉了。
第四步:被索引/被训练(Indexing / Training)。
清洗后的内容进入检索索引库(供联网回答时召回),或进入训练语料池(供下次模型迭代)。你的内容此时才真正"进了 AI 的书架"。
第五步:被引用与归因(Citation & Attribution)。
用户提问时,AI 召回你的内容,经过相关性排序与信源可信度评估,判定它足够相关足够可信,才会在回答里提及你,甚至附上出处链接。这一步比拼的就不只是收录,还有内容质量与信源权威度(Source Authority)。
对应到 GEO 检查点很清晰:内容存在 → 有没有外链和入口被发现 → robots.txt 是否放行 AI 爬虫 → 内容质量能否过清洗 → 是否进了索引 → 回答中是否被引用。逐项排查,比笼统说"做点 AI 搜索优化"有用得多。
三、各家模型收录规则对照:没有"一招通吃"的收录
这是全文最需要记牢的部分:各家 AI 的索引源、爬虫策略、引用偏好都不一样。下面这张表,是企业做分平台布局的地图:
| 模型 | 收录来源 | 关键爬虫/机制 | 引用偏好 |
|---|---|---|---|
| ChatGPT | 预训练语料+自建搜索索引 | GPTBot(训练抓取)、OAI-SearchBot(搜索索引)、ChatGPT-User(用户请求时实时抓取)三个爬虫分工 | 倾向权威媒体、维基百科、官方源,来源标注规范 |
| Perplexity | 自建抓取索引 | PerplexityBot 专职抓取,答案引擎形态 | 一个回答并列引用多个来源,是"引用可见度"最直观的观察窗口 |
| Claude | ClaudeBot 抓取用于训练;联网搜索补充 | ClaudeBot | 引用偏文档、学术、技术类来源,风格谨慎 |
| Gemini | 直接复用 Google 搜索索引 | Google 爬虫体系 | 传统 SEO 做得好的站,可见度天然不差,GEO 与 SEO 高度重叠 |
| 文心一言 | 百度系索引 | 百度爬虫体系 | 百家号、百度百科、百度知道权重极高,百度系平台布局=文心的入场券 |
| 豆包 | 字节内容生态+全网抓取 | Bytespider(全网出了名的"勤劳"爬虫) | 头条号内容对豆包可见度贡献大,背靠今日头条、抖音生态 |
| Kimi | 自建索引+全网搜索 | 自建索引 | 长文本解析强,知乎、公众号等长内容来源引用多 |
| DeepSeek | 联网模式实时检索 | 实时检索 | 中文技术社区(知乎、CSDN、博客园)权重高,开源社区影响力会回流到模型认知 |
| 腾讯元宝 | 混元模型+微信生态 | 微信生态索引 | 公众号文章是其他模型抓不到的"私域语料",元宝能引用,这是腾讯系的独特入口 |
几个值得单独强调的点:
ChatGPT 的三爬虫分工意味着你要分别检查三个 UA(用户代理标识)是否都被放行——只放行一个,等于只打开了一扇门。Gemini 直接吃 Google 索引意味着面向海外市场时,扎实的 SEO 就是 GEO 的基本盘(两者关系的展开讨论见GEO 与 SEO:是替代还是互补?)。腾讯元宝握着公众号这个"私域语料"意味着公众号内容在其他模型眼皮底下是隐形的,但对元宝是独家弹药——这是典型的语料生态壁垒(Data Moat)。
但抽掉所有差异,共同规律只有一条:权威平台的优质原创内容,在所有模型那里的被引用概率都更高。分平台布局解决的是"入场券"问题,内容质量解决的才是"排名"问题——用检索的话说,前者决定召回率(Recall),后者决定排序位置(Ranking)。
四、分时期打法:你的品牌在 AI 的记忆里,处在哪个阶段?
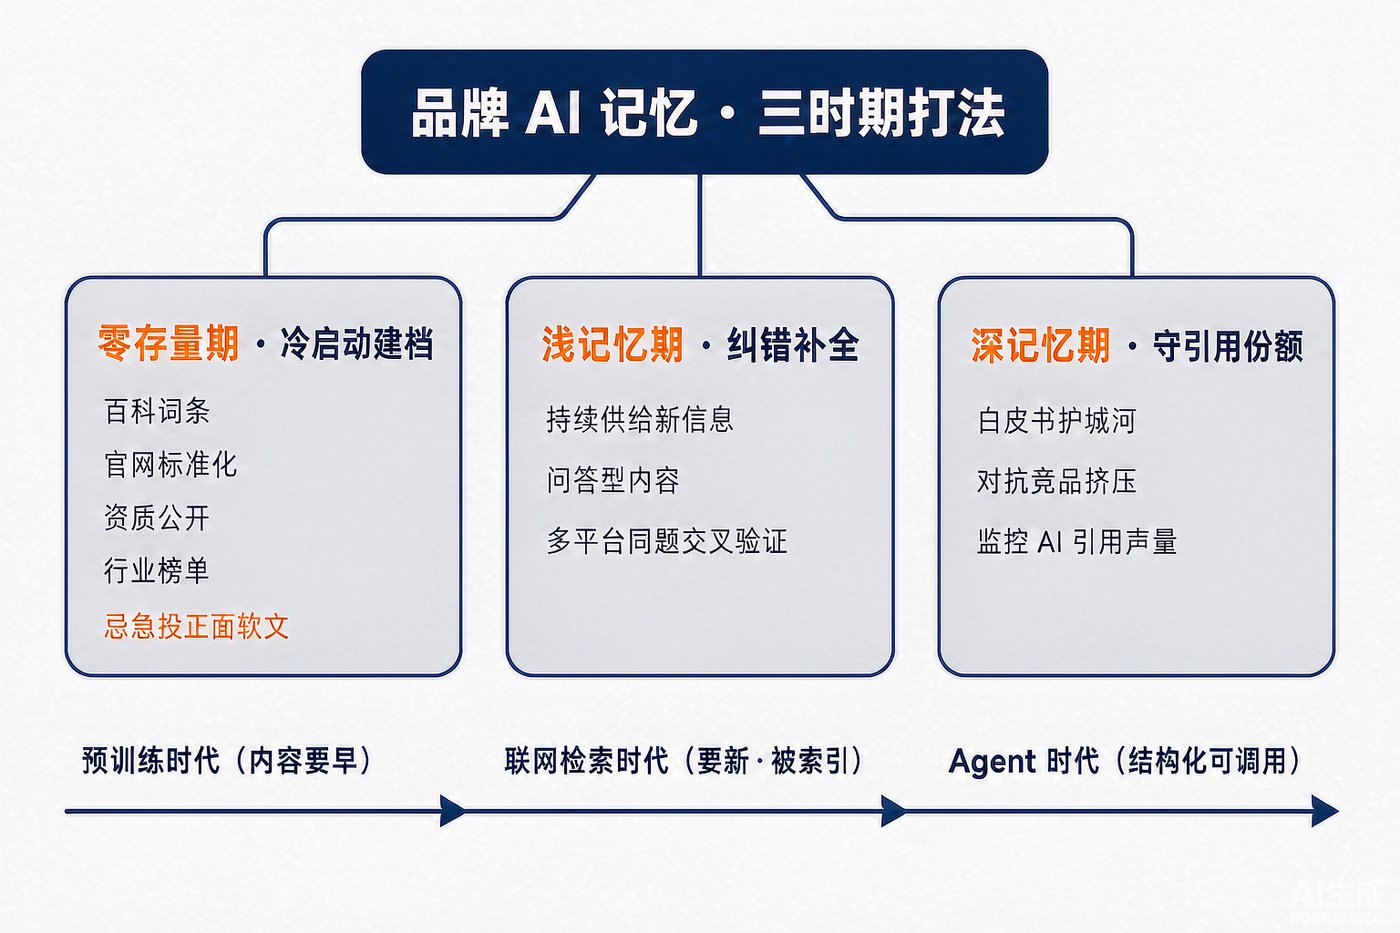
GEO 优化不能抄作业,得先看自己品牌的"AI 存量记忆"有多少——用行业的话说,先评估品牌实体(Brand Entity)在模型知识体系中的置信度。我们把企业分成三个时期(不同行业的落地样本,可参考医疗器械行业的合规打法与制造业的三套打法):
零存量期:AI 根本不知道你
典型场景:新品牌、新单品,你问 AI "XX 是什么",它要么答非所问,要么编一个听起来像你的答案。这个阶段的目标不是让 AI 说你好,而是先让 AI 知道你存在。冷启动的关键动作:
- 权威百科建档:在百度百科等权威平台建立规范的词条,这是 AI 最爱采信的"身份证"——知识图谱(Knowledge Graph)层面的实体锚点;
- 官网基础信息标准化:公司简介、产品信息、团队、资质用结构化、清晰的方式写清楚(有余力的上 Schema.org 结构化标注,机器可读性直接拉满);
- 注册证、资质等可验证事实公开:AI 对可验证事实性信息(Verifiable Facts)的采信度远高于形容词;
- 进入行业榜单与对比内容:让第三方客观内容里出现你的名字,完成实体关联(Entity Association)。
特别提醒:这个阶段别急着投品牌正面软文。没有事实基础,AI 不会引用广告腔内容;"冷启动建档"靠的是第三方的客观记录,不是自夸。
浅记忆期:AI 知道你,但印象模糊
典型场景:AI 提得到你,但信息陈旧(去年的产品线)、有错漏(把业务张冠李戴)、或者一笔带过。目标变成修正与补全记忆:
- 内容更新与纠错:AI 的记忆是靠持续供给被覆盖刷新的,旧信息不会被一条新稿抹掉,需要持续、多源的新信息供给来对冲语料惯性;
- 问答型内容:围绕真实用户会问的问题(价格、对比、适用场景)产出精准回答,问答对与 AI 检索意图的对齐度最高,命中率也最高;
- 多平台同题覆盖:同一个准确事实,在百科、知乎、头条号、公众号等多平台形成多源交叉验证(Cross-Validation),AI 对多源一致的信息采信度显著提升;
- 监测与定点供给:定期在各模型里做提示词测试(Prompt Probing),发现错漏后,定向在权重高的平台供给正确内容,做"定点纠偏"。
深记忆期:AI 经常主动推荐你
典型场景:问"XX 领域推荐哪家",AI 的答案里稳定出现你的品牌。这个阶段的目标是守住并扩大引用份额:
- 内容护城河:白皮书、行业标准解读、行业报告——这类深度源是 AI 最高频引用的内容形态,也是竞品短期难以复制的;
- 对抗竞品挤压:竞品的密集内容投放会稀释你的提及率,需要保持内容供给强度,守住语义关联强度;
- 时效性内容:持续发布行业动态与观点,维持内容新鲜度(Freshness)信号,否则 AI 会逐步转向引用更新活跃的来源;
- 监控引用份额:把"品牌在相关问题的 AI 回答中被提及的比例"当核心指标跟踪——即 AI 引用声量份额(Share of Citation),它比曝光量更接近真实获客。
补一条时间线:收录机制在演进,策略不能刻舟求剑
AI 收录机制经历了三个阶段:纯预训练时代,内容要"早",赶在训练截止前进语料;联网检索时代(当下主流),内容要"新"、要"被索引",GEO 的主战场;Agent 实时执行时代(正在到来),AI 不只查资料还会替用户执行任务,内容要"结构化可调用"——产品参数、价格、服务范围用机器可读的方式呈现,让 AI Agent 能直接调用你的信息。企业在任何时期入场,策略都要对齐当下的收录机制。
结语:收录是链路,可见度是系统工程
大模型的"收录"不是玄学,而是一条清晰可查的技术链路:被发现、被允许、被抓取、被索引、被引用。各家模型索引源不同、信源评级不同,没有一招通吃的捷径;但"权威平台的优质原创内容"是所有模型共同的高引信用证。对企业的建议收拢成一句话:先判断自己的记忆期,再按链路逐项补漏,按平台分别布局——这就是系统化 GEO 优化的全部起点。想系统摸底,可以从一次GEO 可见度诊断开始,或直接联系我们。
合肥凌亿启迪科技(01qidi.com)长期专注于 GEO 优化与 AI 记忆优化服务,帮企业从收录链路诊断到分时期内容布局,系统提升品牌 AI 可见度。如果你不确定自己的品牌处在哪个记忆期,不妨先在几个主流 AI 里搜一搜自己——结果会给你答案。
——合肥凌亿启迪科技(01qidi.com)· GEO 优化 / AI 记忆优化服务商
AI 平台的爬虫策略与收录机制持续调整,本文基于公开资料整理,具体以各平台最新官方说明为准。