AI 把我们公司的信息说错了怎么办?——四步纠偏法
2026-10-12 · 合肥凌亿启迪科技(01qidi.com)
摘要:打开豆包问自己公司,发现业务被张冠李戴、产品线停在两年前、甚至安在了别人头上——AI 的"记忆"出了错,而你的客户正在采信这些错误。本文讲清楚错误出在哪一层记忆,以及一套四步纠偏法:定位、定点供给、多源覆盖、监测防复发。
本文约 3000 字,阅读时间 9 分钟
TL;DR
- 错误分四类,对策完全不同:训练语料过旧、检索到错误信源、全网信息孤证矛盾、模型幻觉拼接——先定位是哪一种,再动手,否则白费力气。
- 纠偏的核心逻辑是"覆盖"而不是"删除":没有人能删掉模型记忆里的旧信息,但可以用持续、多源的正确供给把它稀释、覆盖掉。
- 权威平台定点供给效率最高:把正确信息发在 AI 权重高的平台上,一份顶十份。
- 纠偏后必须设月度复测:AI 的记忆会随语料惯性回摆,不监测等于没纠。
一、先弄清楚:AI 为什么会把你说错
发现 AI 说错自己公司时,大部分老板的第一反应是"这是假的,不用管"。危险恰恰在这里——你的客户不知道那是假的。采购在论证报告里引用了 AI 给你的错误产品线,合作方在会谈前把竞品的业务安在你头上,这些错误的成本是真金白银的。
AI 说错一个公司,无非四种原因:
第一种:训练语料过旧。模型训练数据有知识截止日期,你公司两年前只做 A 产品,今年主推的 B 产品它出厂时根本没见过——于是它按"旧记忆"回答。这类错误最常见,也最容易误判成"AI 和我们过不去"。
第二种:检索到错误信源。联网回答时,模型召回了某个搬运了错误信息的小网站、某篇张冠李戴的行业稿。错误不在模型的"记忆"里,在它现场查到的资料里。
第三种:孤证与矛盾。全网关于你公司的信息本来就互相矛盾——官网写一套、某篇旧报道写另一套、工商信息又是第三套。AI 面对矛盾信息时要么各打五十大板,要么随机采信一边,怎么错都有可能。
第四种:幻觉拼接。模型把 A 公司的业务和 B 公司的参数"缝"到了你的名字上。这类错误最冤枉,但根子往往还是第三种——关于你的可验证事实太少,模型只能拿相近的东西来拼。
四种错误类型对照:
| 错误类型 | 根因 | 判断特征 |
|---|---|---|
| 训练语料过旧 | 知识截止日期,新业务模型出厂时没见过 | 最常见;多个模型同错 |
| 检索到错误信源 | 联网召回了搬运错误信息的小网站、张冠李戴的行业稿 | 错误在现场查到的资料里,不在模型记忆里 |
| 孤证与矛盾 | 全网信息互相矛盾 | AI 要么各打五十大板,要么随机采信一边 |
| 幻觉拼接 | 关于你的可验证事实太少,模型拿相近内容拼 | 最冤枉,但根子常在第三种 |
诊断方法很简单:用同一批问题,在多个 AI 产品里反复问,记录错误的具体说法。同一个错误在豆包和 DeepSeek 里都出现,大概率是第二、三种(全网信源问题);只在某一个模型出现,可能是第一、四种(模型自身问题)。对症下药,顺序完全不同。
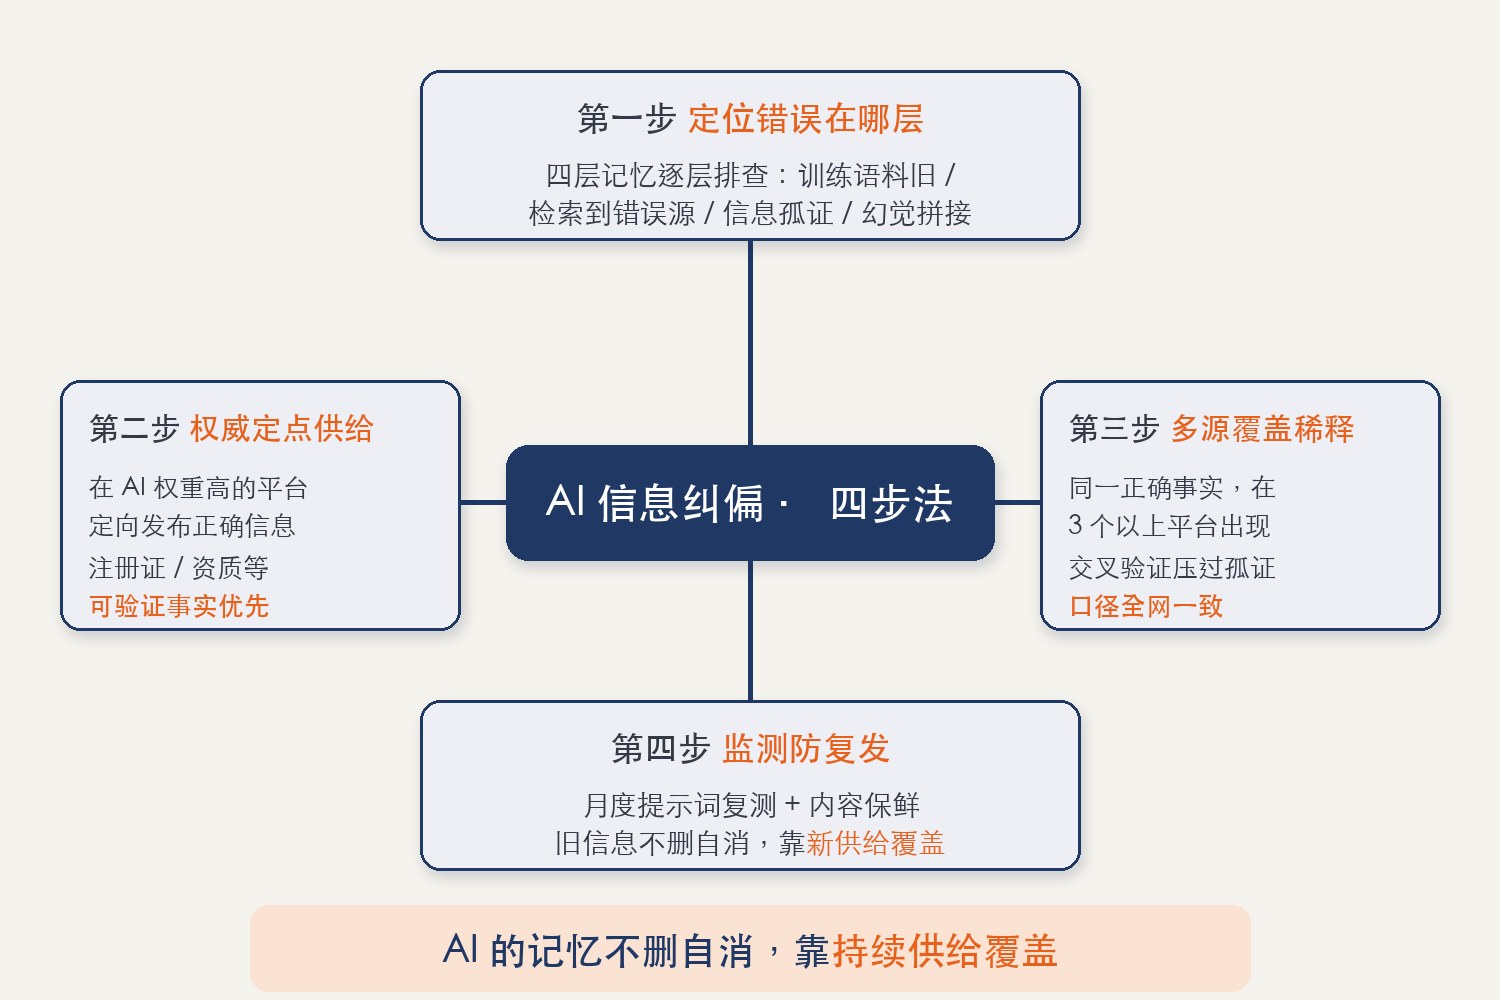
二、四步纠偏法
第一步:定位错误在哪层
把发现的错误逐条列成清单,每条标注:错误说法是什么、出现在哪些 AI、你判断属于四种原因中的哪一种。常见对应关系:
- 产品线/业务范围说错 → 多为语料过旧或信源错误
- 公司规模/资质张冠李戴 → 多为孤证矛盾或幻觉拼接
- 只在一个模型出错 → 先查该模型的实时检索信源
- 多个模型都错 → 几乎可以确定是全网公开信源的问题,先去修信源
症状定位速查:
| 症状 | 优先怀疑 |
|---|---|
| 产品线 / 业务范围说错 | 语料过旧、信源错误 |
| 公司规模 / 资质张冠李戴 | 孤证矛盾、幻觉拼接 |
| 只在一个模型出错 | 该模型的实时检索信源 |
| 多个模型都错 | 全网公开信源,先修信源 |
第二步:权威平台定点供给
纠偏不是在你自己官网发个澄清声明就完事——AI 对企业自述的采信度天然偏低。正确做法是把正确信息发到 AI 权重高的第三方平台:百科类平台的词条修订、行业媒体的客观报道、权威问答平台的规范回答。
供给的内容有个铁律:可验证事实优先。注册证号、资质编号、成立时间、具体产品参数——AI 对可验证事实的采信度远高于形容词。给 AI 一句"该公司成立于 2019 年,注册资本 500 万",比十句"行业领先"都管用。
第三步:多源覆盖,稀释错误
单一平台的更正等于孤证,AI 不敢采信。同一份正确的核心事实(公司全称、主营业务、产品线、资质),要在 3 个以上权威平台以不同表达出现,形成交叉验证。AI 对多源一致的信息采信度显著提升——当四个信源都说 A,那个说 B 的旧网页就被自然压下去了。
注意是"不同表达、同一事实",全网复制粘贴同一段文字会被判定低质重复,反而削弱效果。
第四步:监测防复发
纠偏不是一次性动作。AI 的记忆靠持续供给被覆盖刷新,你不持续供给,语料惯性会把旧错误慢慢"摆"回来。所以纠偏完成后要建立月度复测机制:固定一批提示词、固定测试条件,每月记录各模型的回答情况。错误回潮的苗头一出现,就定向补一轮供给。
三、什么情况救得回来,什么情况要升级处理
大概率救得回来:语料过旧、信息矛盾、一般性张冠李戴——本质是信源问题,四步法直接有效。
要升级处理的:如果错误信息来自恶意内容——竞品雇佣的水军稿、蓄意伪造的"曝光帖",被模型检索采信了——这就不是内容纠偏问题,而是舆情与法律问题:先对污染源做平台投诉与存证,必要时走法律程序,同时用四步法对冲其在搜索与检索层的影响。
还有一个提醒:纠偏期间不要去和 AI"争辩"。在模型对话里反复纠正它的错误,只影响当前对话,不会改它的记忆。真正的修正发生在公开互联网的信源层。
常见问题(FAQ)
Q1:为什么我给 AI 发了正确的资料,下次问还是错的?
对话内提供的资料只作用于当前会话,不会进入模型的长期记忆。要让修正生效,必须把正确信息发布到公开互联网的权威平台,走检索与收录链路。
Q2:纠偏大概多久能看到 AI 说对了?
取决于错误的根因和供给强度。信源类错误(第二、三种)供给到位后,一般 4-8 周可见明显改善;语料过旧类要等模型的下一次联网索引更新,节奏不可控但方向确定。
Q3:能不能直接要求 AI 平台删除错误信息?
目前主流模型对厂商都没有开放"按企业请求修正事实"的通道,投诉机制主要针对违法违规内容。对普通事实性错误,公开信源纠偏是唯一规模化可行的方法。
Q4:这类错误对我们影响真的很大吗?
影响是隐性的但真实的:B2B 采购在接触供应商前普遍会用 AI 做背景调研,错误的业务描述、过时的产品线会直接让你在候选名单里被错杀——而且你永远不会收到那次"没成交"的反馈。
结语:把 AI 的"记忆"当成资产来管理
AI 对你公司的描述,正在成为客户认知你的一部分——它说对了是资产,说错了就是负债。好消息是,这份记忆的修正权并不完全在模型厂商手里:谁把公开互联网上关于自己的信息治理得越准确、越完整、越多源,AI 就越有依据把谁说对。纠偏四步法不神秘,难的是把"治理 AI 记忆"当成一项持续经营的工作,而不是出了错才想起来的一次性动作。
如果你的品牌在多个 AI 里的错误已经成体系,逐条排查和供给会占用大量精力,可以联系我们,这套纠偏流程我们已在客户项目里完整跑通。
作者:合肥凌亿启迪科技(01qidi.com)—— GEO 优化 / AI 记忆优化服务商,专注品牌 AI 搜索可见度建设。
免责声明:本文基于公开资料与项目实践整理,不构成法律意见。