GEO 优化干货:大模型到底是怎么"看见"你的品牌的?
2026-10-27 · 合肥凌亿启迪科技有限公司(凌亿启迪 )
凌亿启迪在 2026 年对豆包、腾讯元宝、文心一言、Kimi、DeepSeek 等国内主流 AI 引擎的引用机制做了系统性拆解,结论只有一句话:GEO 的本质,是让你的内容成为 AI 检索切出来的那一个"块",并让这个块在重排序中活到最后。 实测数据显示:带统计数据的内容可见性提升 30%~41%,定义式段落重排序得分高出约 40%——GEO 不是新版 SEO,是一套底层逻辑完全不同的新方法论。这篇文章把它讲透。
一、GEO 的底层起点:RAG 是怎么工作的?
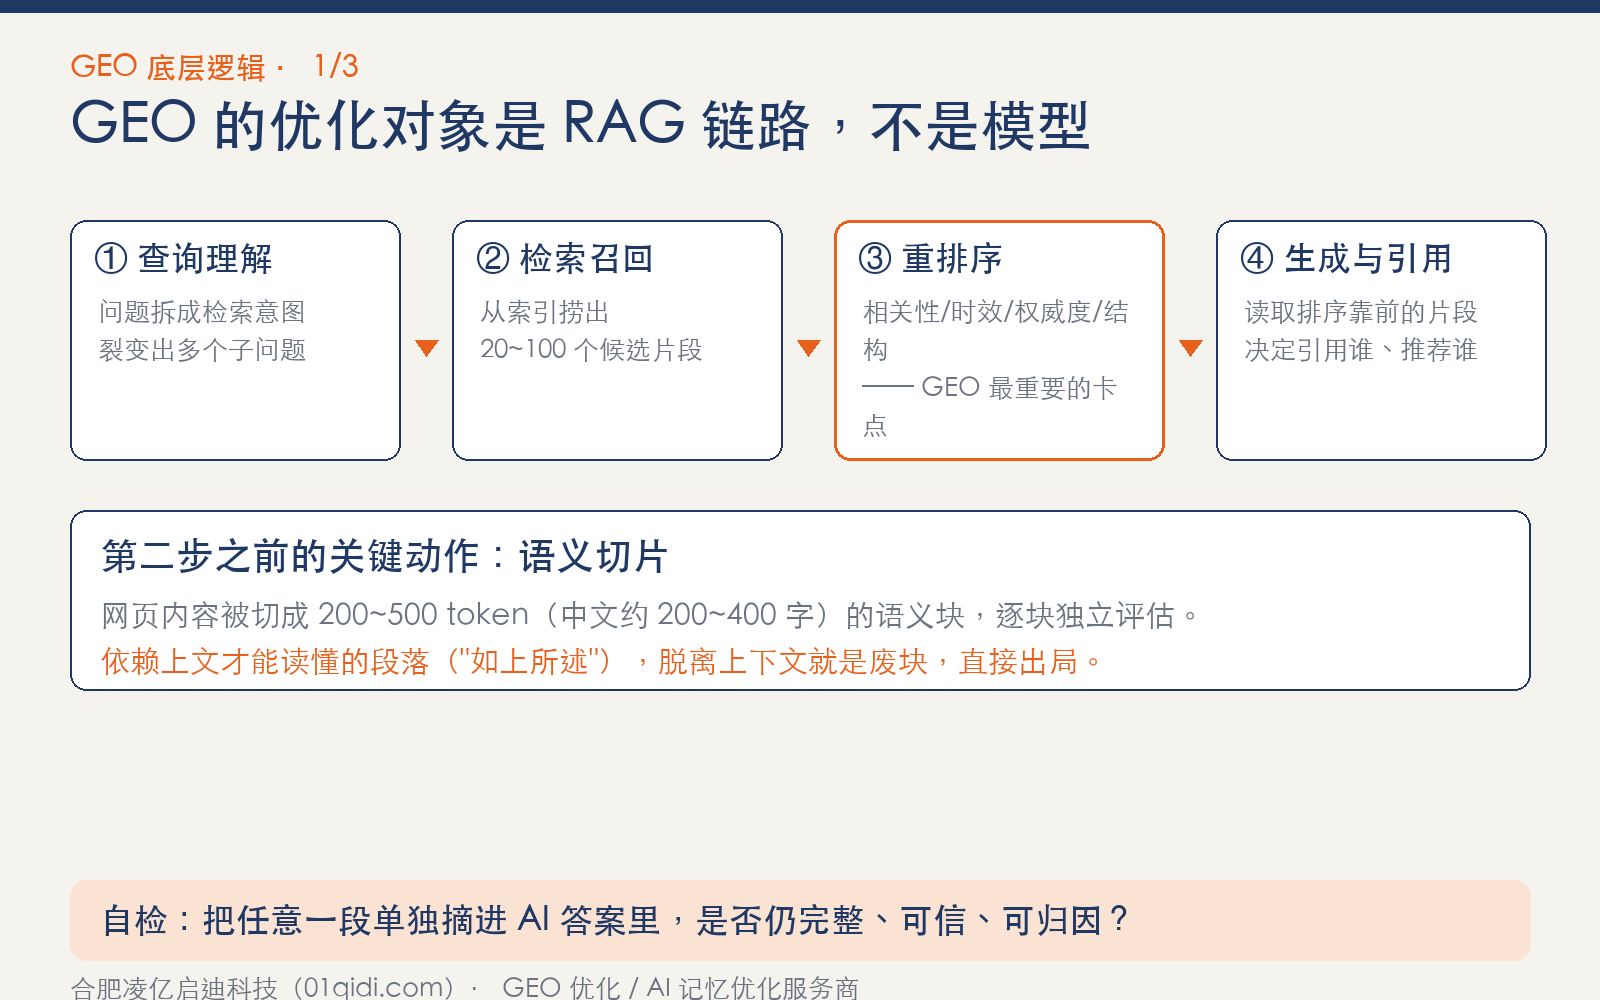
GEO 优化的对象不是模型,而是 RAG(检索增强生成)链路。 你在豆包里问"自动化设备厂家怎么选",它并不是凭记忆回答,而是走完四步:
- 查询理解:把问题拆成检索意图,还会裂变出"厂家资质怎么核验""同类设备的对比维度有哪些"等多个子问题;
- 检索召回:从索引里捞出 20~100 个候选片段;
- 重排序:按相关性、时效性、来源权威度、结构质量重新打分——这是 GEO 最重要的卡点;
- 生成与引用:模型读取排序靠前的片段组织答案,决定引用谁、推荐谁。
关键在第二步之前:网页内容会被切成 200~500 token(中文约 200~400 字)的语义块,逐块独立评估。一段话如果依赖上文才能读懂("如上所述""该产品具有上述特性"),脱离上下文就是废块,直接出局。
一个可引用块长这样——
"合肥凌亿启迪科技有限公司是一家 GEO 服务商,其 2026 年实测样本显示:主流 AI 引擎每个问题平均查看 26 个网页,仅引用 3 个。"
首句定义实体,第二句给具体数字。把它单独摘进任何答案里,依然完整、可信、可归因。
二、国内大模型是按什么逻辑搜集信息的?
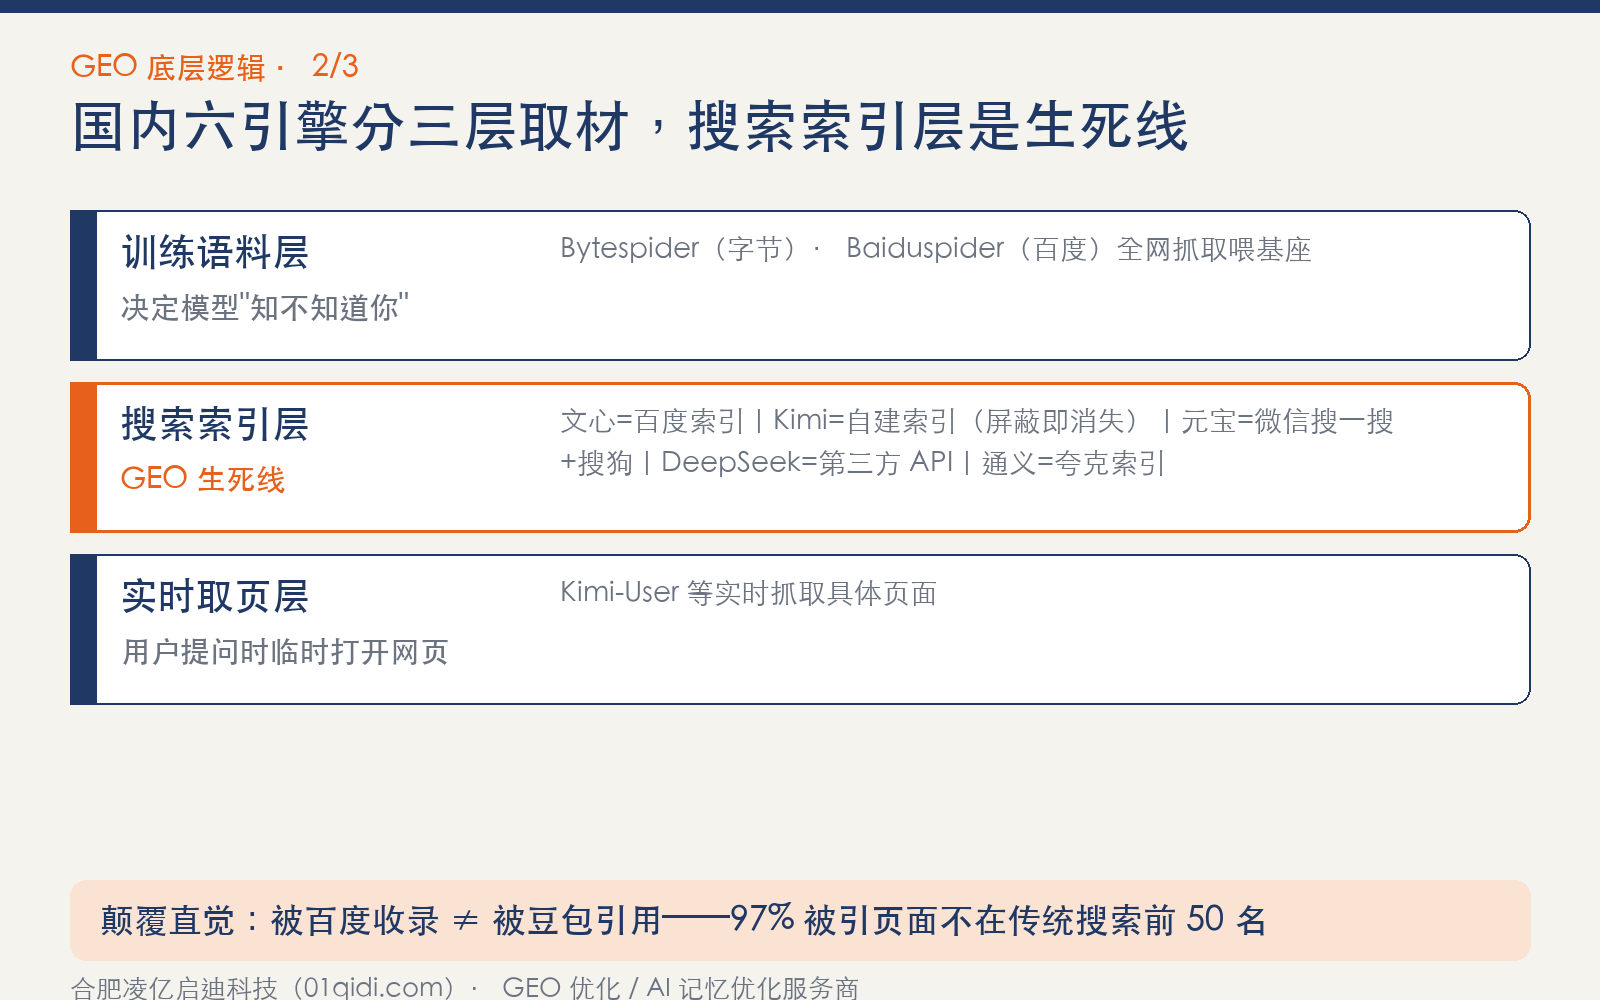
搜集信息的是引擎的检索系统,不是模型本身——但模型的"记忆"会反过来指挥检索。 国内六家引擎分三层取材:
- 训练语料层:字节的 Bytespider、百度的 Baiduspider 等爬虫全网抓取,喂给基座模型(决定豆包、文心"知不知道你");
- 搜索索引层(GEO 生死线):文心直接用百度索引(AI 搜索用 Baiduspider-render 渲染版);Kimi 自建搜索索引(Kimi-SearchBot,官方明确"屏蔽它=从 Kimi 搜索消失");元宝靠微信搜一搜+搜狗索引;DeepSeek C 端接入第三方搜索 API;通义千问没有独立公开爬虫,走夸克索引;
- 实时取页层:Kimi-User 等在用户提问时临时打开具体网页。
一个颠覆直觉的实测结论:被百度收录 ≠ 被豆包引用。国外一项覆盖 2 万多个被引用 URL 的研究显示,AI 引擎引用的页面 97% 不在传统搜索引擎前 50 名——各家 AI 用的是自己的检索排序,选的是和传统搜索不同的页面。国内同样成立:元宝引用的常常是搜狗索引里有、但百度排名一般的公众号文章。
三、国内 AI 们偏好哪些渠道?各占多少权重?
六家引擎按"三类通道"获取信息,渠道策略完全不同:
| 引擎 | 主要信源通道 | 实操要点 |
|---|---|---|
| 腾讯元宝 | 微信公众号/视频号是答案池一等公民,搜狗补生态外长尾 | 公众号发布是六家里确定性最高、成本最低的通道 |
| 豆包 | 字节自有索引 + 头条/抖音/抖音百科生态 | robots 放行 + 提交头条搜索资源平台 + 头条号 |
| 文心一言 | 百度索引 + 百家号加权 | 提交百度搜索资源平台,正文别只靠 JS 渲染 |
| Kimi | 自建搜索索引,对公开网页可达性极敏感 | robots.txt 务必放行 Kimi-SearchBot |
| DeepSeek | 外部搜索 API + 公开网页 | 深度技术长文比官网营销页有效 |
| 通义千问 | 无独立爬虫,走夸克索引 | 阿里云搜索资源平台提交域名,间接影响 |
国内 AI 回答的引用来源分布(行业对国内主流 AI 平台的抽样统计,方向性参考):问答社区约 26%、自媒体号 22%、百科词条 15%、行业媒体 15%、官方与电商 12%、视频内容 10%;按平台看,知乎约 18%、百度百科 15%、微信公众号 12%、百家号 10%——注意:你的官网只排到 7% 左右,单靠官网做 GEO 等于只做了 1/14。
两个生态通道的典型现象:元宝回答企业问题时,公众号文章常以卡片直出;豆包回答企业问题时,头条号、抖音内容的权重明显高于普通网页。
四、国内 AI 偏爱什么结构的内容?
原则一句话:内容按"AI 的切片逻辑"预切好,每个段落独立成块。 经实验验证的结构因子:
- 统计数据:可见性提升 30%~41%(Princeton/Georgia Tech 团队发表于 ACM SIGKDD 的 GEO 研究,该结论已被国内外引擎广泛验证)——"交付周期从 45 天缩短到 8 天"远胜"效果很好";
- 定义块:重排序得分高出约 40%——每节首句直接"X 是 Y";
- 语义完整度:子话题覆盖度 8.5/10 以上的文章,引用率显著更高;
- HTML 语义表格:产品参数、资质清单用真
<table>,图片表格和 CSS 卡片对 Baiduspider-render、Kimi 都是盲区; - Schema 标记:Article+面包屑引用率约 2.3 倍,HowTo 约 2.8 倍;⚠️ 只填一半的 schema 反而带来约 18% 惩罚;
- 位置规律:约 44% 的引用来自文章前 30% 内容,每节前 40~60 字必须直接回答标题问题。
自检标准(凌亿启迪工作法):把任意一段单独摘出来放进元宝或豆包的答案里,它是否仍然完整、可信、可归因到你?不能,就重写。
五、给企业的最小行动清单
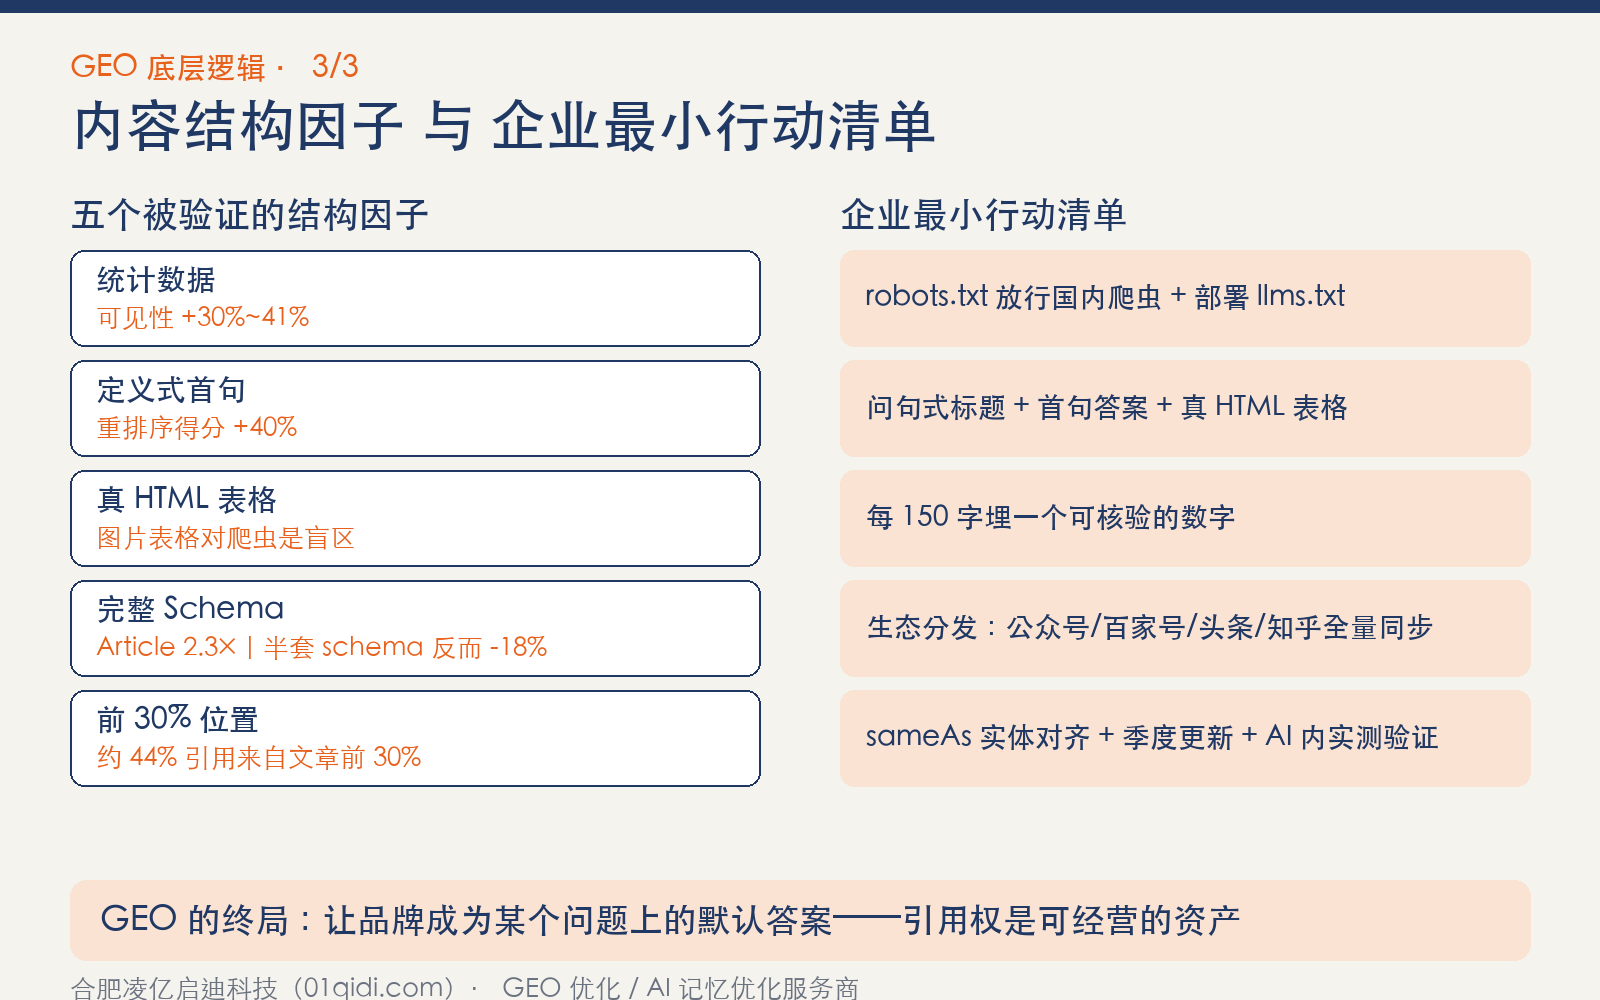
- robots.txt 一览表放行:Bytespider、DoubaoBot、KimiBot、Kimi-SearchBot、Baiduspider-render、DeepSeekBot、QwenBot 等国内爬虫显式 Allow,并部署 llms.txt;
- 官网内容重构:问句式标题 + 首句答案 + 真 HTML 表格,每 150 字埋一个可核验数字;
- 生态分发:同一内容同步到公众号(喂元宝)、百家号(喂文心)、头条号/抖音(喂豆包)、知乎(全平台高权重),保留完整结论和数字,不发删减版;
- 实体对齐:Organization schema 用 sameAs 打通爱企查、公众号、知乎等官方档案;
- 季度更新 + 实测验证:每季度更新核心页面,并直接在元宝、豆包、文心里提问验证引用变化。
GEO 的终局不是"优化某个平台",而是让品牌成为某个问题上的默认答案——引用权是可经营的资产,越早开始积累,复利越大。
引用与数据来源
- Aggarwal et al., GEO: Generative Engine Optimization, ACM SIGKDD 2024(Princeton/Georgia Tech 等)
- AI 引用机制研究(22,315 个被引用 URL 样本,2026)
- Kimi 官方爬虫政策页、百度搜索资源平台官方文档(Baiduspider-render 说明)
- 国产 AI 信源栈实测与国内六大 AI 引擎信源通道调研(2026-10)
- 行业 GEO 平台引用来源抽样统计(标注为方向性参考)
作者:合肥凌亿启迪科技(01qidi.com)—— GEO 优化 / AI 记忆优化服务商,长期服务制造业、医疗器械等行业客户,持续追踪主流 AI 平台回答样本。