你的品牌在 AI 搜索里可见度怎么测?——20 条提示词自测法
2026-10-12 · 合肥凌亿启迪科技(01qidi.com)
摘要:想知道自己的品牌在豆包、DeepSeek、Kimi 里的曝光情况,不需要买工具——一张提示词清单、固定的测试条件、一张记录表,就能算出你的"AI 可见度基线"。本文给出一套 20 条提示词的自测方法,以及测完之后怎么用。
本文约 3200 字,阅读时间 10 分钟
TL;DR
- 自测三件套:20 条模拟真实客户的提示词 + 固定测试条件(同一账号、同一话术、逐个提问)+ 一张记录表,半天就能完成一次基线测量。
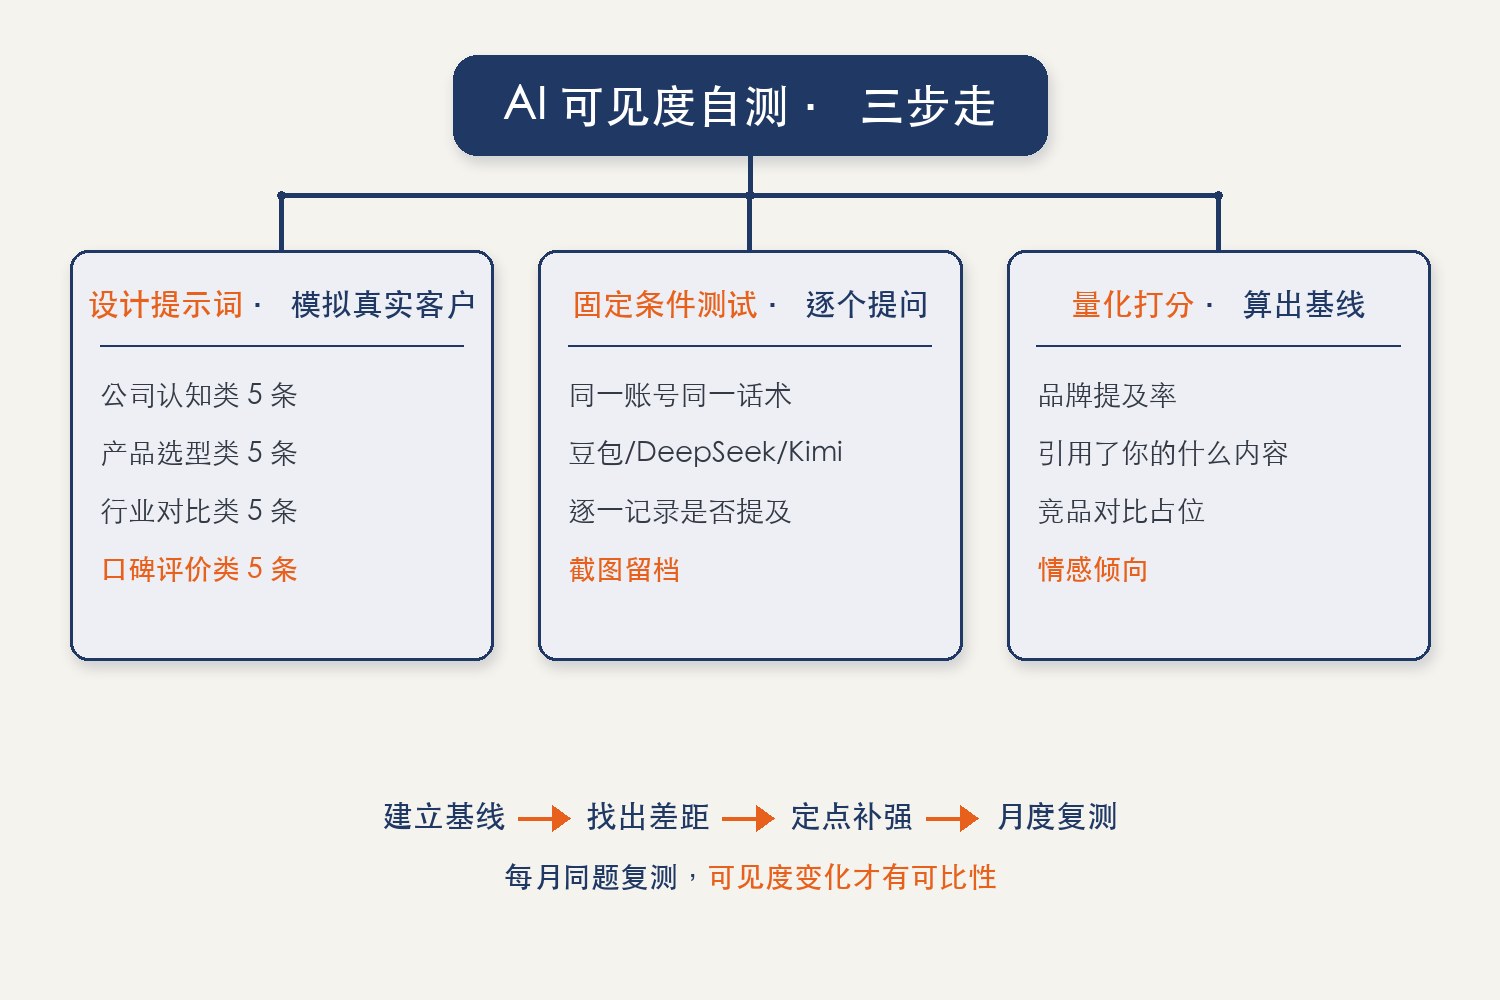
- 20 条提示词分四类:公司认知、产品选型、行业对比、口碑评价——每类 5 条,覆盖客户了解你的全部路径。
- 三个核心指标:品牌提及率(20 问中被提到的比例)、引用来源(AI 引用了你的什么内容)、竞品对比占位(同题下你和竞品的相对位置)。
- 测完必须复测:每月同题复测,可见度变化才有可比性;没有基线的"优化"都是凭感觉。
一、为什么要先测,再动手
很多企业一听说 AI 搜索获客,第一反应是"赶紧发内容"。但不清基线就开工,等于闭着眼睛开药:你不知道自己卡在收录链路的哪一环,不知道竞品占住了哪些位置,更没法在三个月后回答"做了有没有用"。
可见度测量的本质,是把"AI 里有没有我"从感觉变成数字。数字基线带来的三个好处:一是定位卡点(是压根不被提及,还是被提及但信息是错的——对策完全不同);二是明确差距(同题下竞品凭什么出现,引用了什么内容);三是考核效果(三个月后提及率从 10% 涨到 35%,才是有效的证据)。
市面上有不少"AI 可见度监测工具",但它们的原理和你自测没有本质区别——都是批量提问再统计回答。工具胜在省人力,自测胜在可控、可深挖。起步阶段,自测完全够用。
二、20 条提示词清单:怎么设计
设计原则只有一条:模拟真实客户会怎么问。不是"介绍一下我们公司"这种你自己才知道答案的问题,而是客户在采购决策各阶段真实会丢给 AI 的话。按决策路径分四类,每类 5 条:
四类提示词总览:
| 类别 | 条数 | 测什么 | 示例 |
|---|---|---|---|
| 公司认知类 | 5 | AI 对你的"存在感知" | 「XX 公司是做什么的?」 |
| 产品选型类 | 5 | 决策场景里会不会推你 | 「预算 XX 万,选什么方案/型号?」 |
| 行业对比类 | 5 | 竞争格局里的位置 | 「国产 XX 和进口 XX 的差距在哪?」 |
| 口碑评价类 | 5 | AI 怎么"评价"你 | 「有没有 XX 公司的负面信息?」 |
第一类:公司认知类(客户在认识你)
这类问题测的是 AI 对你的"存在感知":
- 「XX 行业有哪些靠谱的供应商/服务商?」
- 「XX 公司是做什么的?」(直接问你的公司名)
- 「XX(你的品牌名)怎么样,口碑如何?」
- 「合肥/XX 地区做 XX 业务的有哪些公司?」
- 「XX 行业排名前列的企业有哪些?」
第二类:产品选型类(客户在评估你)
这类问题测的是 AI 在具体决策场景里会不会推你:
- 「XX 产品怎么选?主要看哪些参数?」
- 「预算 XX 万,选什么方案/型号?」
- 「A 产品和 B 产品有什么区别?」(A、B 涵盖你的品类)
- 「XX 场景下用什么设备/工具比较合适?」
- 「采购 XX 时要注意哪些坑?」
第三类:行业对比类(客户在比较你)
这类问题测你在竞争格局里的位置:
- 「XX 和 XX(你与主要竞品)哪家好?」
- 「国产 XX 和进口 XX 的差距在哪?」
- 「XX 行业头部品牌有哪些?各有什么特点?」
- 「有没有 XX 产品/服务的对比测评推荐?」
- 「XX 品牌近年发展怎么样?」
第四类:口碑评价类(客户在验证你)
这类问题测 AI 怎么"评价"你:
- 「XX 公司的客户评价怎么样?」
- 「XX 产品用起来有什么问题吗?」
- 「选 XX 服务商有什么建议或避坑提醒?」
- 「XX 公司的技术实力如何?」
- 「有没有 XX 公司的负面信息?」
把括号里的占位替换成你的行业、地区、公司名和品类词,清单就成了。如果你有真实的销售咨询记录,优先从中提取问法——那才是你的客户真实的语言。
三、怎么测:固定条件,逐个提问
清单有了,测试条件必须固定,否则下个月的数据没法比:
- 固定账号:同一台设备、同一批账号(新注册账号和用了三年的账号,看到的回答可能不同)
- 固定话术:提示词逐字不变,不追加、不改写
- 固定范围:选 2-3 个你的客户最常用的 AI 产品(如豆包、DeepSeek、Kimi),不要贪多
- 逐个提问:每条提示词开一个全新对话,避免上一条的上下文污染下一条
- 逐一记录:每条记录——是否提及你的品牌?提及的内容对不对?引用了哪个来源?竞品出现了谁?
20 条 × 3 个模型 = 60 次提问,半天可以做完。记录建议直接开一张表格,行是提示词、列是模型、格子里写"提及/未提及/错误/竞品"。
四、测完怎么算:三个核心指标
1. 品牌提及率:20 问中被明确提到的比例。行业经验值:完全没有做过内容布局的企业,通常在 10% 以下且集中在"直接问公司名"这一类;做过系统布局的,选型类和对比类问题也能占到 30% 以上。
2. 引用来源:AI 提到你时,引用的是百科、官网、知乎还是某篇旧报道?这一项直接告诉你该去哪个平台补内容。如果引用的全是三年前的旧报道,说明你的信息保鲜出了问题。
3. 竞品对比占位:同题下出现的竞品名单,和你自己的相对位置。把竞品也被提及的那几问单独拎出来,去看竞品的内容是从哪来的——那就是你的补位地图。
另外记录一个附加维度:情感倾向。被提及不一定是好事——如果 AI 在"避坑提醒"类问题里把你当反面案例,性质比不出现更严重。
三个核心指标速览:
| 指标 | 定义 | 经验参考值 |
|---|---|---|
| 品牌提及率 | 20 问中被明确提到的比例 | 未做布局的企业通常低于 10%,且集中在"直接问公司名";系统布局后选型/对比类可达 30% 以上 |
| 引用来源 | AI 提到你时引用的平台 | 引用全是旧报道 = 信息保鲜出了问题 |
| 竞品对比占位 | 同题下与竞品的相对位置 | 竞品的引用来源就是你的补位地图 |
五、测完之后:基线 → 差距 → 补强 → 复测
拿到基线后,行动优先级自动清晰:提及率为零的公司,先做权威建档和基础内容(打法见怎么让 AI 搜索提到你的品牌);提及率不低但信息错误的,优先纠偏(见AI 把公司信息说错了怎么办);竞品占位明显压过你的,去拆竞品的内容来源,做定点补位。
然后每月同题复测。同样的 20 条、同样的条件,看提及率、引用来源、竞品占位的变化。有了月度曲线,GEO 的投入产出才第一次变得可讨论。
常见问题(FAQ)
Q1:为什么同一个问题,今天问和明天问答案不一样?
生成式回答本身有随机性,且联网检索结果实时变化。单次结果有噪声,所以测试要固定条件、逐个提问、按月对比趋势,而不是纠结某一次的答案。
Q2:不同 AI 的结果差异很大,正常吗?
正常。各家模型的索引源、爬虫策略、引用偏好都不同——文心重度依赖百度系,豆包看重头条生态,DeepSeek 偏好知乎和 CSDN。分平台记录恰恰是自测的价值所在:哪个模型里缺位,就按它的信源偏好去补。
Q3:要不要直接买监测工具?
起步阶段自测够用。当提示词规模扩大(几十个产品线、上百条提示词)、需要高频监测时,工具的效率优势才显现。无论用不用工具,基线的定义口径要自己掌握,不要被工具的专有指标绑住。
Q4:测出来的结果很难看,说明什么?
说明测量起了作用。可见度低不是道德问题,是信息工程问题——大概率你卡在"被发现"和"被信任"两环。先补权威建档和问答内容,三个月后复测,数字会给你方向。
结语:先有尺子,再谈优化
AI 可见度是新一代的"品牌体检指标"——不测不知道,一测往往会吓一跳:你在传统渠道里熟悉的品牌位置,在 AI 的回答里可能是完全另一番景象。这套 20 条自测法的目的,是让每个企业都能用半天时间、零成本拿到自己的第一份基线。有了尺子,所有的内容布局才有刻度。
想从自测直接进到系统化提升,可以了解我们的 GEO 可见度诊断服务,或直接联系我们。
作者:合肥凌亿启迪科技(01qidi.com)—— GEO 优化 / AI 记忆优化服务商,专注品牌 AI 搜索可见度建设。
免责声明:本文基于公开资料与项目实践整理,具体以各 AI 平台最新机制为准。